
Le 12 fatiche del CyberOP
Con l'uso dell'AI, è aumentato il numero di vulnerabilità riscontrate: una strategia per identificarle e mitigarle di Simona Venuti, responsabile di GARR Cert.
Non so se i miei dieci lettori si ritroveranno nel mood, ma nell'ultimo periodo una fetta importante del mio lavoro quotidiano è trascorsa nell’analisi di numerose vulnerabilità di ogni genere, che hanno un impatto piuttosto forte sulle nostre infrastrutture.
Le vulnerabilità sono di diversi tipi, e spaziano da sistemi operativi, protocolli, applicativi, supply chain. Sono state riscontrate numerose vulnerabilità nel kernel Linux, e in ssh, che permettono escalation di privilegi, nelle librerie npm (di nuovo!), dovute alla compromissione degli account dei loro repository ufficiali (di nuovo!), che si propagano rapidamente in tutte le catene di software autoprodotto e nella catena DevOps che abbiamo nelle nostre organizzazioni, vulnerabilità in applicativi vari, come Joomla! e WordPress, ma soprattutto nei loro plugin sviluppati da terze parti, vulnerabilità in hardware anche nei processori, vulnerabilità nei router, nei firewall, nei VPN server, di cui sono anche uscite liste di credenziali funzionanti…
Insomma, ho attraversato varie giornate di sconforto in cui mi sono detta: non si può riuscire a stare dietro a tutto questo, cercare gli impatti, mitigare e/o patchare tutto e rimanere mentalmente equilibrati!
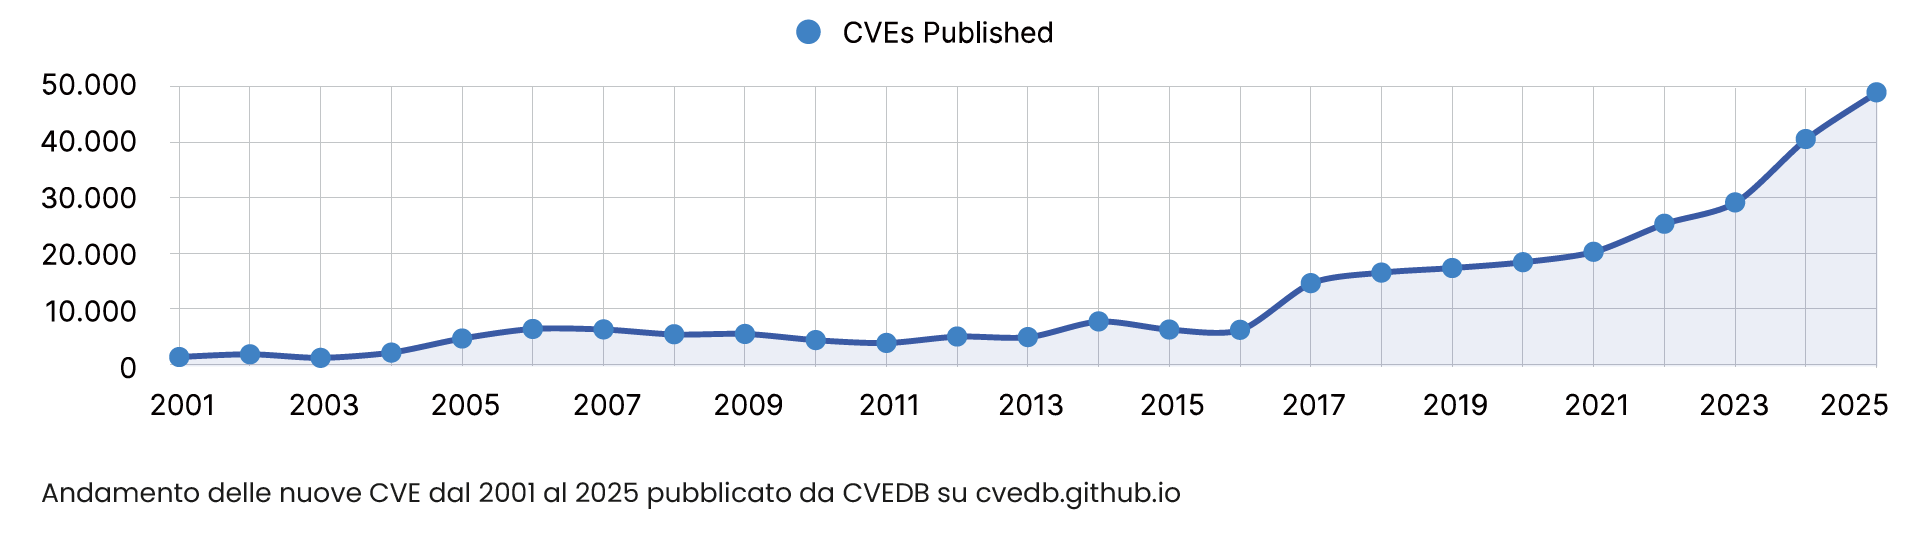
Ho deciso quindi di affrontare la questione senza farmi prendere dal panico e dalla frustrazione. La prima cosa che salta agli occhi è che il numero di CVE (Common Vulnerabilities and Exposures) aumenta vertiginosamente ogni anno: si passa da circa 1.700 nuove CVE nel 2001 a 48.000 nel 2025. L’aumento del numero di vulnerabilità, fino ad un certo punto era dovuto al fatto che le aziende mettevano a disposizione di esperti di sicurezza programmi di BugBounty, in cui ogni vulnerabilità scoperta poteva fruttare anche una ricompensa in denaro, oltre alla gloria. Ma è indubbio che la maggior parte delle vulnerabilità scoperte ultimamente sia dovuto all’aiuto dell’intelligenza artificiale applicata all’analisi del software, che gli esperti di sicurezza utilizzano massicciamente per partecipare a programmi di BugBounty.
Il numero di CVE aumenta vertiginosamente ogni anno: dal 2001 al 2025 si è passati da 1.700 a 48.000 nuove CVE
Tutto questo è ovviamente un bene, perché rilevare bug nei sistemi permette ai produttori di correggerli e rendere il mondo un po’ più sicuro, ma purtroppo è anche un male, perché spesso questi bug non sono correttamente gestiti, non sono replicabili o sono doppioni, i produttori del software impiegano molto tempo a capire se la vulnerabilità sia vera, doppione, o allucinazione, a volte anche le patch vengono “commissionate” all’intelligenza artificiale, che combina disastri e apre altri bug. Si sta creando più confusione che sicurezza.
La situazione è diventata talmente caotica che addirittura Linus Torvalds, autore del kernel Linux, si è lamentato apertamente sulla questione, dicendo che sì, l’intelligenza artificiale è bella e utile nel trovare vulnerabilità, ma i bug rilevati devono essere gestiti in maniera più strutturata, per garantire che vengano tracciati e risolti. Per mitigare il caos, Torvalds propone che chiunque decida di sottomettere un bug rilevato dalla AI, si meriti di studiare e sottomettere anche la documentazione necessaria alla riproducibilità, ed eventualmente una proposta di patch, in modo da aggiungere valore al lavoro della AI, che potrebbe essere svolto da chiunque.
Se perfino i grandi guru hanno difficoltà a gestire le vulnerabilità, figuriamoci noi poveri mortali che dovremo patcharle o mitigarle! Come possiamo fare per non perderci?
L’approccio che mi è sembrato più sensato è quello dell’analisi del rischio. Lo so che è difficile e noioso, e rispunta sempre come il prezzemolo nelle ricette di cucina, ma è l’unico modo di valutare e bilanciare, di creare una metodologia in mezzo alla tempesta. Quindi, supponendo che non posso studiare nel dettaglio ciascuna delle 50 vulnerabilità che mi arrivano ogni giorno, proverò a guardare quelle considerate più gravi, andando a guardare il CVSS di ciascuna.
Il CVSS è un indice, studiato da FIRST, calcolato secondo una metodologia standard, per valutare la gravità di una vulnerabilità, e va da 1, per quelle meno gravi, a 10, per quelle critiche.
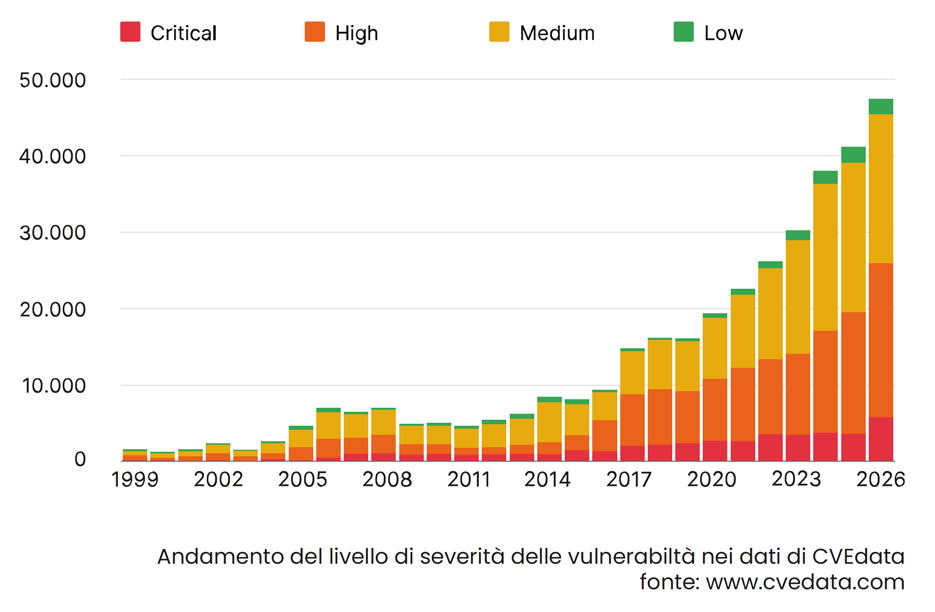
Potrei dunque decidere di occuparmi soltanto delle vulnerabilità con CVSS da 8 in su. Ma a questo punto incappo in un altro problema: la severità delle CVE sta pericolosamente aumentando negli anni, cioè ogni anno le CVE sono un po’ più gravi del precedente.
Inoltre, il calcolo del CVSS è cambiato nel tempo, e man mano che il numero di CVE aumenta, il MITRE, l’organismo preposto a gestire CVE a livello mondiale, ha delegato i singoli produttori e altri organismi a gestire le proprie CVE, col risultato che spesso il CVSS non è calcolato uniformemente, e da qualcuno è gonfiato per motivi anche di marketing. Sul sito del CVE data, da cui ho preso l’immagine sopra, sono spiegate molte delle problematiche legate a CVSS e CVE.
Indipendentemente dalle questioni gestionali e politiche, il CVSS inizia a non essere più di molto aiuto per capire quando una vulnerabilità può essere pericolosa per la mia struttura, perché ci fornisce soltanto il potenziale impatto, e non la misura di quanto essa sia sfruttabile e sfruttata: non ci dice per esempio se esiste un exploit, o se sia facile crearlo.
Per cercare di avere un quadro più completo di questo aspetto, che rende una CVE più pericolosa per noi, sono stati creati ulteriori indicatori e cataloghi, come per esempio il Known Exploited Vulnerabilities Catalog (KEV), di CISA, che in parole semplici ci dice se esiste un exploit disponibile per una certa CVE. Sapere che esiste già un exploit disponibile e funzionante è utile perché ci aiuta nel decidere che tipo di politica di patching o mitigazione poter usare, ci indica quanto sia più o meno urgente dedicarsi a quella particolare vulnerabilità.
Le cattive notizie sono che anche il trend del numero di exploit disponibili aumenta nel tempo: si va da circa 300 KEV nel 2021 agli oltre 1.400 exploit disponibili nel 2025. Il problema non è solo legato al numero: spesso esistono vulnerabilità non documentate, gli 0-day per esempio, che sono ampiamente sfruttate già da prima del loro rilevamento e pubblicazione. Nel 2025 VulnCheck ha rilevato che 28,96% delle KEV identificate per la prima volta nel 2025 risultavano già sfruttate alla data di pubblicazione del CVE o prima, in aumento rispetto al 23,6% nel 2024.
Un altro fattore di cui tener conto che incide sull’analisi del rischio di una vulnerabilità è il Time to Exploit, che misura il tempo che intercorre fra la scoperta di una vulnerabilità e il momento in cui inizia ad essere sfruttata. Questo tempo fino agli anni ’20 era di circa un anno, ma dal 2020 si è enormemente ristretto, fino ad arrivare a 21 giorni nel 2025.
La situazione sta diventando dura da gestire, il primo pensiero che viene in mente, per mia esperienza personale, è quello di “mollare”… troppi input spingono in uno stato di apatia, frustrazione, inazione… si rimane fermi imbambolati a guardare e contare le cose da fare (senza farle).
Ma invece è proprio il momento in cui i duri iniziano a giocare! Rimbocchiamoci le maniche e cerchiamo di dare struttura e criterio.
- Mi interessano soltanto le vulnerabilità della mia struttura. Sebbene sia interessante, istruttivo e divertente sapere come funziona l’ultima vulnerabilità uscita, se non fa parte della mia struttura la lascio ad un secondo momento.
- Conosco la mia struttura. La cosa importante è conoscere e aver contezza di ciò che usiamo, implementiamo e sviluppiamo all’interno della struttura, quali sono i nostri asset, sia hardware che software, in modo da concentrarci solo su quelli.
- Automatizzare il più possibile. Ci sono software per i quali quando esce un aggiornamento non si sta a pensare se sia utile o problematico, si fa e basta. Per esempio gli aggiornamenti dei sistemi desktop: sistemi operativi, antivirus, browser, mail client, PDF viewer, e molti altri. Dopo averli censiti è facile configurare gli aggiornamenti automatici che queste applicazioni hanno già implementato e sono a disposizione.
- Focus sulla pericolosità. Per vulnerabilità non automatizzabili, indipendentemente dalla gravità (CVSS), conviene andare a vedere il KEV, per sapere se esiste l’exploit.
- Assegnare priorità. Creare una lista di priorità di patch in base all’importanza dell’asset coinvolto e la possibilità che la vulnerabilità sia sfruttata. Aiutarsi con il documento di analisi del rischio per valutare i sistemi da patchare per primi.
- Sistemare i sistemi importanti, non la vulnerabilità. Una singola vulnerabilità potrebbe avere un impatto su molte macchine all’interno della nostra struttura, e tutti i giorni dobbiamo gestire ben più di una vulnerabilità. Piuttosto che patchare a tappeto una singola vulnerabilità per volta, e dichiarare la struttura “sicura per quella problematica”, è meno rischioso patchare i sistemi più importanti, per quella vulnerabilità, e per tutte le altre che impattano su di loro, e lasciare i sistemi meno importanti per dopo.
- Mitigare. Per gli asset meno urgenti si possono valutare operazioni di mitigazione, per esempio chiudendo provvisoriamente porte, bloccando IP o classi di indirizzi, o AS number. Se il sistema non è essenziale si potrebbe anche metterlo offline in attesa della sua patch.
- Aggiornamenti più aggiornati di altri. Valutare di diminuire l’intervallo di aggiornamento per alcuni sistemi di software, principalmente appartenenti a software di terze parti/supply chain. Quando le librerie NPM sono state compromesse il problema è stato rilevato e risolto in circa 15 minuti, rimettendo online le librerie sane. Se io faccio un aggiornamento ogni 24 ore e prendo le librerie corrotte, poi avrò 24 ore in cui sono completamente vulnerabile, fino al prossimo aggiornamento automatico. Se facessi aggiornamenti più frequenti avrei una libreria risanata molto prima.
- Gestione degli aggiornamenti. Prevedere un sistema di tracciabilità degli aggiornamenti da fare e fatti sui sistemi, per non dimenticarsi o perdere pezzi.
- Diffondere le informazioni. Una struttura difficilmente ha tutti i sistemi centralizzati e sotto il proprio controllo, sicuramente ci sono sistemi in gestione ad altre persone, secondo una catena di distributed accountability. Queste persone, per la sicurezza di tutti, sono tenute ad aggiornare i propri sistemi come gli altri. Può essere un servizio utile, nel momento in cui si processano le vulnerabilità, creare dei bollettini che possono essere spediti ad una mailing-list o inseriti in un sito web, in modo da poter essere consultati. I bollettini per essere leggibili facilmente e soprattutto rapidamente devono essere precisi, sintetici, con i dati importanti (CVE, KEV etc) e rimandare ai link dei produttori.
- Sviluppo software. Per le strutture che producono anche software proprio potrebbe essere utile istituire un servizio di analisi del software, oppure un servizio mirato di informazioni su sorgenti e librerie, corsi di formazione alla sicurezza per gli sviluppatori, controllo della catena di DevOps.
- Prepararsi! Con tutte queste vulnerabilità, per quanto si cerchi di strutturare e stare dietro a tutto, è comunque facile perdere tracce, asset, o avere troppi aggiornamenti in coda, o non poter fare alcuni aggiornamenti per problemi di compatibilità. Quindi la probabilità che la vulnerabilità si trasformi in una compromissione o un incidente è in aumento. Prepararsi alla gestione degli incidenti con procedure, ruoli, funzioni e modalità di escalation aiuta a gestire la situazione se si dovesse arrivare al peggio.
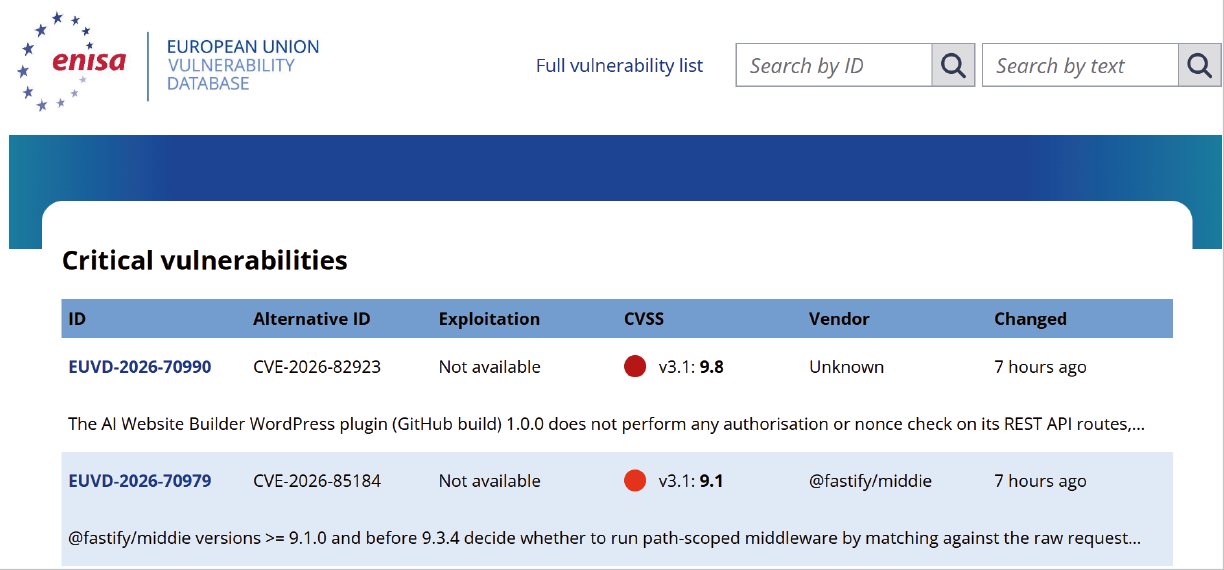
La dashboard di ENISA che raccoglie tutte le informazioni utili è disponibile online: euvd.enisa.europa.eu - credits: ENISA
Concludendo
Il patch management, già problematico di per sé, sta ponendo questioni anche di overworking e quantità di task da gestire. Quello che possiamo fare, come poveri mortali a corto di risorse extra, è cercare di dare struttura, ordine, tracciabilità, focalizzarsi solo sui propri asset, e farsi aiutare dal documento di analisi del rischio, senza farsi prendere dallo sconforto.
Bonus track: Me lo sono lasciata per ultimo, ma questo può dare una mano. ENISA ha fatto qualcosa per inserire in una stessa dashboard le informazioni utili: CVE, CVSS, KEV (e anche la predittibilità di un exploit: FIRST-EPPS – Exploit Prediction Scoring System).
In breve
Perché il numero di vulnerabilità (CVE) scoperte ogni anno sta crescendo così rapidamente?
Perché l'intelligenza artificiale viene ormai usata massicciamente dagli esperti di sicurezza per analizzare il software e partecipare a programmi di BugBounty, individuando molte più vulnerabilità di quanto avvenisse in passato: si è passati da circa 1.700 nuove CVE nel 2001 a oltre 40.000 nel 2025. Questo aumento porta benefici in termini di sicurezza, ma genera anche confusione, perché non tutte le segnalazioni vengono gestite in modo strutturato.
Perché il punteggio CVSS da solo non basta più per decidere quali vulnerabilità patchare per prime?
Perché il CVSS misura solo il potenziale impatto di una vulnerabilità, non quanto essa sia effettivamente sfruttabile o già sfruttata. Per questo si affiancano altri indicatori, come il KEV (Known Exploited Vulnerabilities Catalog) di CISA, che segnala se esiste già un exploit disponibile, e il ""Time to Exploit"", ovvero il tempo che intercorre tra la scoperta di una vulnerabilità e il suo sfruttamento reale: un intervallo che nel 2025 si è ridotto a circa 21 giorni.


